آخر مراجعة: 3 سبتمبر 2026. الـWorkflow الذي يعمل مرة واحدة أمامك ليس بالضرورة Workflow موثوقًا. في التشغيل الحقيقي ستواجه API بطيئًا، Rate Limit، بيانات ناقصة، خدمة خارجية متوقفة مؤقتًا أو Node تتلقى قيمة لم تتوقعها. لذلك فإن التعامل مع أخطاء n8n ليس إضافة متقدمة؛ هو جزء أساسي من بناء أتمتة يمكن الاعتماد عليها.
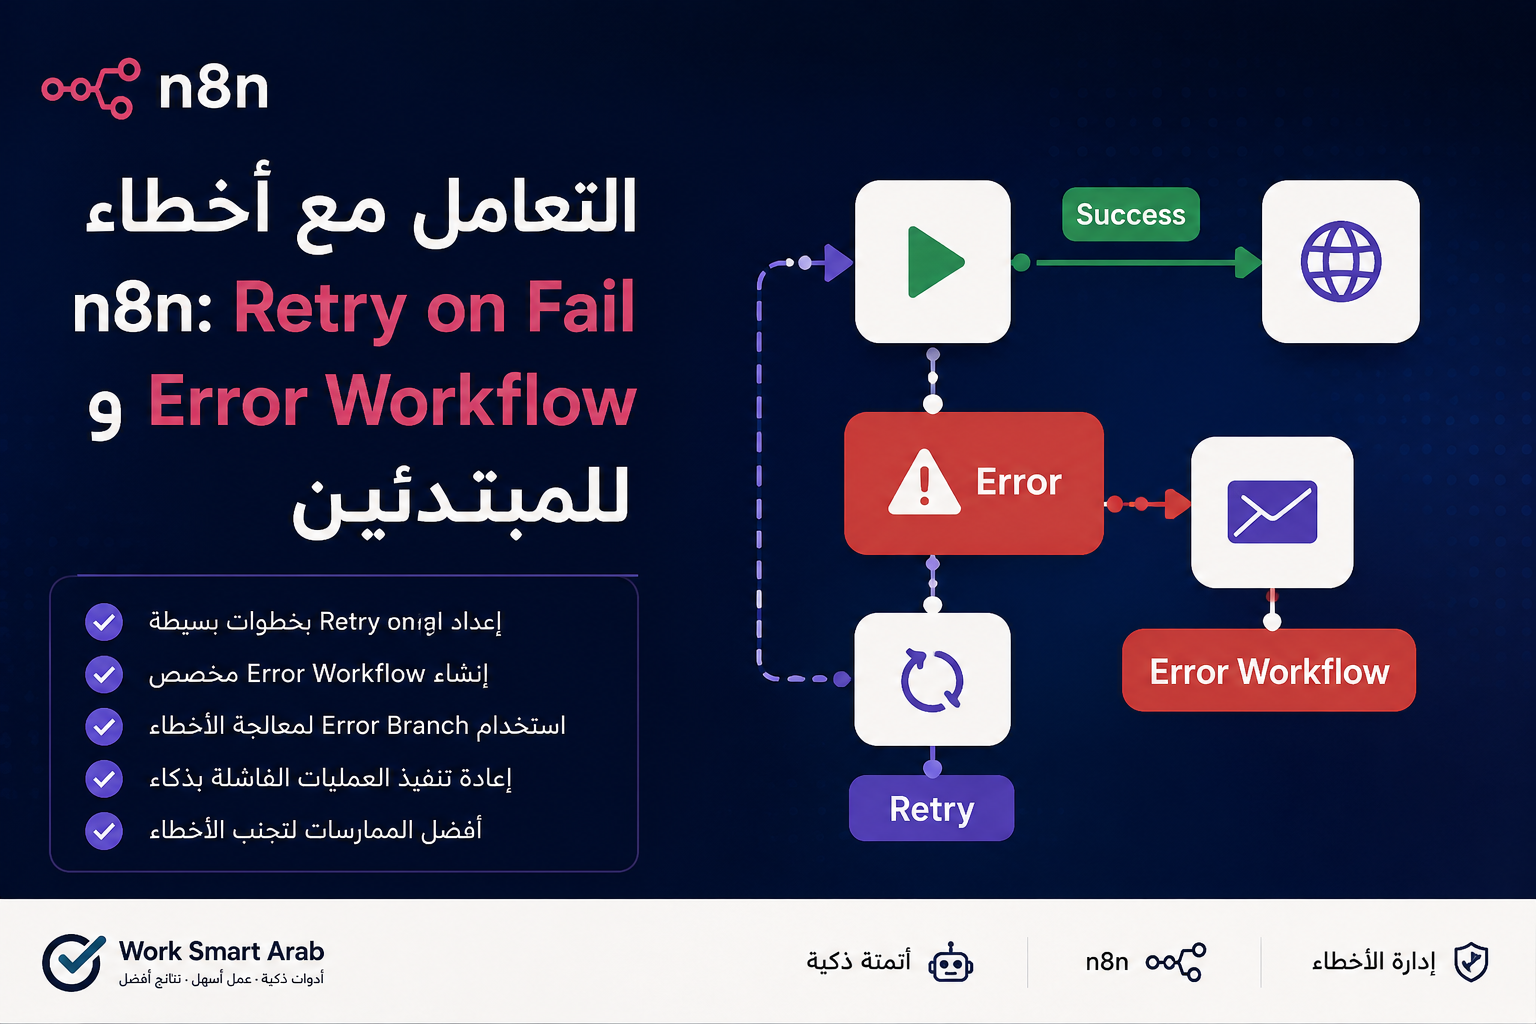
في هذا الدليل سنفصل بين أربع أدوات مهمة: Retry on Fail، ومسار الخطأ داخل الـNode، وError Workflow المركزي، وإعادة محاولة التنفيذ الفاشل. ثم نبني قاعدة قرار بسيطة تساعدك على اختيار الطريقة الصحيحة بدل تفعيل Retry على كل شيء.
الخلاصة السريعة: ماذا تفعل عندما يفشل Workflow في n8n؟
| نوع المشكلة | الإجراء الأنسب |
|---|---|
| خطأ مؤقت من API أو انقطاع قصير | Retry on Fail بعدد محاولات محدود |
| سجل واحد سيئ وسط دفعة كبيرة | استخدم مسار خطأ/استمرار مدروس بدل إيقاف العملية كلها |
| فشل Workflow مهم في الإنتاج | Error Workflow لإرسال تنبيه وتفاصيل التنفيذ |
| خطأ منطقي أو بيانات غير صحيحة | لا تكرر المحاولة عشوائيًا؛ أصلح المدخل أو المنطق |
| فشل بعد كل المحاولات | سجل الحادثة وأرسلها للمراجعة البشرية |
القاعدة الأساسية: Retry مناسب للأخطاء المؤقتة، وليس للأخطاء الدائمة.
أولًا: ما الفرق بين الخطأ المؤقت والخطأ الدائم؟
قبل إعداد أي معالجة، صنّف الخطأ. مثال على الأخطاء المؤقتة: Timeout، انقطاع اتصال، أو خدمة خارجية تعيد 502 أو 503 لفترة قصيرة. في هذه الحالات قد تنجح نفس العملية بعد ثوانٍ دون تغيير أي شيء.
أما الأخطاء الدائمة فتشمل مثلًا مفتاح API غير صالح، حقل مطلوب مفقود، Endpoint خاطئ، أو بيانات لا تقبلها الخدمة. إعادة نفس الطلب خمس مرات لن تصلح المشكلة، وقد تزيد الضوضاء أو التكلفة.
هناك فئة ثالثة تحتاج حذرًا: 429 Too Many Requests. هذا خطأ مؤقت عادةً، لكنه يعني أنك تجاوزت Rate Limit، لذلك إعادة المحاولة فورًا قد تعيد نفس الخطأ. هنا تحتاج انتظارًا قبل المحاولة التالية.
1. استخدام Retry on Fail داخل الـNode
في إعدادات عدد كبير من Nodes داخل n8n يمكنك تفعيل Retry on Fail. الفكرة أن n8n يعيد محاولة تشغيل الـNode بعد الفشل بدل إنهاء التنفيذ مباشرة.
هذا مناسب عندما تكون العملية آمنة لإعادة المحاولة، مثل طلب قراءة بيانات من API أو استدعاء خدمة قد تتوقف لثوانٍ.
إعداد مبدئي عملي
- ابدأ بـ2 أو 3 محاولات، لا بعشرات المحاولات.
- ضع وقت انتظار معقولًا بين المحاولات.
- راقب نوع الخطأ بدل افتراض أن كل فشل مؤقت.
- إذا كانت الخدمة ترسل تعليمات Retry-After أو توثق حدودًا معينة، اتبعها.
توفر مكتبة n8n الرسمية أمثلة لأنماط Retry أكثر تقدمًا، بما فيها إعادة المحاولة مع منطق يفرق بين الأخطاء المتوقعة وغير المتوقعة، بدل تكرار كل فشل بالطريقة نفسها. راجع مثال Retry on fail except for known error.
متى يكون Retry خطيرًا؟
لا تنظر فقط إلى إمكانية نجاح الطلب في المرة الثانية. اسأل أيضًا: ماذا يحدث إذا نجح الطلب الأول فعليًا لكن الرد ضاع قبل أن يصل إلى n8n؟
مثال: Node ترسل طلبًا لإنشاء فاتورة. الخدمة تنشئ الفاتورة، لكن الاتصال ينقطع قبل عودة الاستجابة. n8n يظن أن العملية فشلت ثم يعيدها، فتُنشأ فاتورة ثانية.
لهذا السبب يجب التعامل بحذر مع العمليات ذات Side Effects مثل:
- إنشاء سجل جديد.
- إرسال بريد أو رسالة.
- تنفيذ دفعة أو طلب مالي.
- إنشاء تذكرة أو فاتورة.
- تعديل حالة لا يمكن التراجع عنها بسهولة.
إذا كانت الخدمة تدعم Idempotency Key فاستخدمه عندما يكون ذلك مناسبًا. وإلا أنشئ تحققًا يمنع التكرار، مثل البحث عن السجل قبل إنشائه أو حفظ معرف خارجي فريد.
2. متى تسمح للـWorkflow بالاستمرار بعد الخطأ؟
ليس كل خطأ يستحق إيقاف Workflow كامل. تخيل أنك تعالج 200 صف من Google Sheets، ويوجد صف واحد ينقصه البريد الإلكتروني. قد يكون من الأفضل فصل هذا السجل وإرساله للمراجعة بدل خسارة معالجة 199 صفًا سليمًا.
هنا استخدم خيارات الخطأ في الـNode لتوجيه البيانات الفاشلة إلى مسار منفصل عندما تكون طبيعة العملية تسمح بذلك.
لكن لا تستخدم «استمر رغم الخطأ» كطريقة لإخفاء الأعطال. إذا تجاهلت الخطأ دون تسجيله، قد يبدو الـWorkflow ناجحًا بينما جزء من العمل لم ينفذ.
المسار الأفضل
- نفذ العملية الأساسية.
- إذا نجحت، أكمل المسار الطبيعي.
- إذا فشلت، التقط رسالة الخطأ والمدخل المرتبط بها.
- صنّف الخطأ.
- أرسل السجل إلى Queue أو Sheet أو Database للمراجعة.
- أرسل تنبيهًا فقط عندما تكون المشكلة مهمة فعلًا.
3. Error Workflow: مركز مراقبة واحد للأخطاء
إذا كان لديك عدة Workflows، لا تريد بناء Telegram أو Email Node داخل كل واحد منها فقط لإخبارك أن شيئًا فشل. الحل الأنظف هو إنشاء Error Workflow مركزي.
الفكرة:
- أنشئ Workflow مستقلًا لمعالجة الأخطاء.
- ابدأه بـError Trigger.
- أضف خطوات تسجيل أو تنبيه.
- اربط الـWorkflows المهمة بهذا الـError Workflow من إعداداتها.
عند فشل Workflow مرتبط به، يستقبل معالج الأخطاء معلومات عن التنفيذ، ما يسمح لك ببناء رسالة تتضمن اسم الـWorkflow، رسالة الخطأ، آخر Node تم تنفيذها ورابط التنفيذ عندما يكون متاحًا.
ما الذي يجب أن يحتويه تنبيه الخطأ؟
- اسم الـWorkflow.
- وقت الفشل.
- اسم آخر Node أو نقطة الفشل.
- رسالة الخطأ الأساسية.
- Execution ID أو رابط التنفيذ.
- معرف العميل/الطلب إذا كان آمنًا ومفيدًا.
- درجة الخطورة: Warning أو Critical مثلًا.
تجنب إرسال Payload كامل يحتوي بيانات عملاء حساسة إلى Telegram أو Slack لمجرد سهولة التشخيص. أرسل أقل قدر يكفي لتحديد الحادثة، ثم افتح التنفيذ من بيئة n8n الآمنة للمراجعة.
4. إعادة محاولة Execution كامل: متى تصلح؟
إعادة محاولة الـNode ليست نفس إعادة تنفيذ Workflow كامل. أحيانًا تكون كل العملية قابلة للتكرار بأمان ويكون Retry على مستوى التنفيذ منطقيًا. لكن في Workflows أخرى قد تكون الخطوات السابقة نفذت تغييرات حقيقية بالفعل، وإعادة العملية من البداية قد تكرر هذه الآثار.
مكتبة n8n تعرض أنماطًا لمراقبة التنفيذات الفاشلة ثم إعادة المحاولة تلقائيًا، مثل Auto-retry engine. استخدم هذا النوع من الأنماط بعد فهم حالات الفشل والـIdempotency، لا كزر «إصلاح كل شيء».
نموذج Workflow بسيط لمعالجة الأخطاء
لنفترض أن لديك Workflow يستقبل Lead عبر Webhook ثم يضيفه إلى CRM ويرسل إشعارًا.
البنية الأولية:
Webhook
  ↓
Validate Data
  ↓
Create/Update CRM Record
  ↓
Send Notification
طبقة الاعتمادية:
Webhook
  ↓
Validate Data
  ├─ invalid → Review Queue
  ↓ valid
CRM Node (limited retry)
  ├─ failure → Error branch / log
  ↓ success
Notification

Global Error Workflow
  ↓
Log incident
  ↓
Alert when severity requires it
إذا لم تكن فكرة الـWebhook واضحة لك بعد، ابدأ من شرح Webhook في n8n خطوة بخطوة.
لماذا لا نريد Retry فوريًا وبشكل متكرر؟
إذا كانت الخدمة الخارجية تحت ضغط أو تطبق Rate Limit، إرسال المزيد من الطلبات فورًا قد يزيد المشكلة. النمط الأفضل في بعض الأنظمة هو Exponential Backoff: الانتظار يزداد مع كل محاولة، مثل 5 ثوانٍ ثم 10 ثم 20، مع حد أقصى مناسب.
توجد قوالب n8n رسمية توضح هذا الأسلوب مع Jitter لتقليل تزامن المحاولات بين عمليات متعددة. الفكرة ليست أن تنسخ أي قيمة افتراضية بلا تفكير، بل أن تجعل سياسة Retry متوافقة مع الخدمة التي تتصل بها.
قائمة تحقق قبل تشغيل Workflow في الإنتاج
- ☐ حددت الـNodes التي تتصل بخدمات خارجية.
- ☐ عرفت أي الأخطاء مؤقت وأيها دائم.
- ☐ لم أفعّل Retry بصورة عمياء على العمليات التي قد تنشئ نسخًا مكررة.
- ☐ يوجد Validation للبيانات قبل العمليات الحساسة.
- ☐ يوجد سجل واضح للتنفيذات الفاشلة.
- ☐ الـWorkflows المهمة مرتبطة بمعالج أخطاء مركزي.
- ☐ التنبيهات تحتوي معلومات كافية للتشخيص دون تسريب بيانات حساسة.
- ☐ اختبرت سيناريو فشل حقيقي، لا سيناريو النجاح فقط.
- ☐ أعرف ما الذي سيحدث بعد استنفاد كل المحاولات.
اختبار عملي في 15 دقيقة
- اختر Workflow تجريبيًا وليس عملية إنتاج حساسة.
- استخدم Node تتصل بخدمة خارجية أو Endpoint تجريبي.
- اجعل الطلب يفشل عمدًا بإعداد غير صحيح مؤقتًا.
- راقب التنفيذ ورسالة الخطأ.
- فعّل Retry بعدد محدود واختبر السلوك.
- أنشئ Error Workflow بسيطًا يسجل اسم الـWorkflow والخطأ.
- اربط Workflow الاختبار بمعالج الأخطاء.
- أعد الاختبار وتأكد أن لديك مسارًا واضحًا من الفشل إلى التشخيص.
Retry أم Error Workflow أم Error Branch؟
| الأداة | تستخدمها عندما | لا تستخدمها عندما |
|---|---|---|
| Retry on Fail | الفشل مؤقت والعملية آمنة للتكرار | الخطأ دائم أو التكرار قد ينشئ Duplicate |
| Error Branch | تريد معالجة العنصر الفاشل داخل نفس المنطق | تريد مراقبة مركزية لكل Workflows |
| Error Workflow | تريد تسجيل وتنبيه مركزيًا | تحتاج إصلاح البيانات داخل المسار الأساسي نفسه |
| Retry Execution | العملية كاملة قابلة للتكرار بأمان | الخطوات السابقة أحدثت آثارًا غير قابلة للتكرار |
أخطاء شائعة في معالجة أخطاء n8n
- Retry لكل شيء: يحول الأخطاء الدائمة إلى استهلاك إضافي وتأخير.
- Continue لكل شيء: يجعل التنفيذ يبدو ناجحًا رغم فقدان بيانات.
- تنبيه عند كل خطأ صغير: يؤدي إلى Alert Fatigue ثم تبدأ بتجاهل التنبيهات المهمة.
- عدم حفظ السياق: رسالة «Workflow failed» وحدها لا تساعد على التشخيص.
- اختبار مسار النجاح فقط: الاعتمادية تظهر عندما تفشل الخدمات أو تصل بيانات سيئة.
أين تضع معالجة الأخطاء في رحلة تعلم n8n؟
إذا كنت في البداية، لا تبدأ ببناء نظام Incident Management معقد. اتبع التسلسل التالي:
- افهم Workflow وTrigger وNodes من دليل n8n للمبتدئين.
- تعلم استقبال الأحداث من دليل Webhook.
- أضف Validation وRetry محدودًا.
- بعد تشغيل أكثر من Workflow، أنشئ Error Workflow مركزيًا.
- عندما تكبر العمليات، أضف Logging وتصنيفًا للحوادث وسياسات Retry مختلفة حسب الخدمة.
الخلاصة
الـWorkflow الاحترافي ليس الذي لا يفشل؛ بل الذي يفشل بطريقة متوقعة وقابلة للتشخيص والاسترداد. استخدم Retry للأخطاء المؤقتة، وافصل البيانات السيئة بدل تعطيل الدفعة كاملة عندما يكون ذلك آمنًا، واربط العمليات المهمة بـError Workflow حتى تعرف ما حدث دون فحص كل Workflow يدويًا.
وعندما يصبح لديك عدد أكبر من عمليات الأتمتة، راجع أيضًا مقارنة n8n Cloud وSelf‑Hosted لأن مسؤولية المراقبة والصيانة تختلف حسب طريقة الاستضافة.
المعلومات هنا تعليمية وتعتمد على خصائص n8n المتاحة وقت المراجعة. راجع وثائق n8n وإعدادات الـNode والخدمة الخارجية التي تتصل بها قبل تطبيق Retry على عمليات إنتاج حساسة.
Pingback: ما هو n8n؟ دليل المبتدئ للأتمتة وبناء أول Workflow (2026)
Pingback: HTTP Request في n8n: ربط أي API خطوة بخطوة للمبتدئين
Pingback: Loop Over Items في n8n للمبتدئين: التكرار وBatching وتجنب Rate Limits - Work Smart Arab